Google Cloud’un yeni araştırması, Google Cloud AI ReasoningBank aracılığıyla yapay zeka ajanlarının tarihsel sınırlılıklarından biri olan operasyonel amneziyi çözmeyi hedefliyor.
Bu araç sayesinde ajanlar, hataları ve başarıları yeniden kullanılabilir stratejilere dönüştürebiliyor ve her seferinde yeni görevleri ilk kez yapıyormuş gibi ele almak zorunda kalmadan bellek sorununu aşabiliyor.
Yeni framework, Google Cloud AI araştırmacıları tarafından Illinois Urbana-Champaign Üniversitesi ve Yale Üniversitesi ekipleriyle birlikte sunuluyor.
Hedef açıklaması basit ama gerçekleştirilmesi iddialı: yapay ajanların gerçekten öğrendiklerini hatırlamasını sağlamak.
İçindekiler
Google Cloud AI ReasoningBank, daha verimli akıllı ajanlar için yeni bir bellek türü sunuyor
Bilindiği üzere, yapay zeka ajanları giderek daha sık otonom web gezintisi, online alışveriş, yazılım hata ayıklama, ticket yönetimi ve daha pek çok somut görev için kullanılıyor.
Temel sorun, mevcut sistemlerin çoğunun kalıcı şekilde öğrenememesi. Nitekim görev tamamlandığında, o ana kadar biriktirdikleri deneyim, pek de kullanışlı olmayan çerçeveler içinde arşivlenmiş halde kalıyor.
Makaleye göre iki geleneksel yaklaşım mevcut:
- trajektori belleği, tıklamaları, sorguları ve ham eylemleri kaydeder
- iş akışı belleği, yalnızca başarılı prosedürleri saklar
Ancak her ikisi de belirgin sınırlılıklar gösteriyor. İlki bilgi gürültüsü üretiyor. İkincisi ise çoğu zaman en değerli öğrenme kaynağı olan başarısızlıkları tamamen göz ardı ediyor.
İşte tam da bu bağlamlarda Google Cloud AI ReasoningBank paradigmayı anlamlı biçimde değiştirmeye çalışacak.
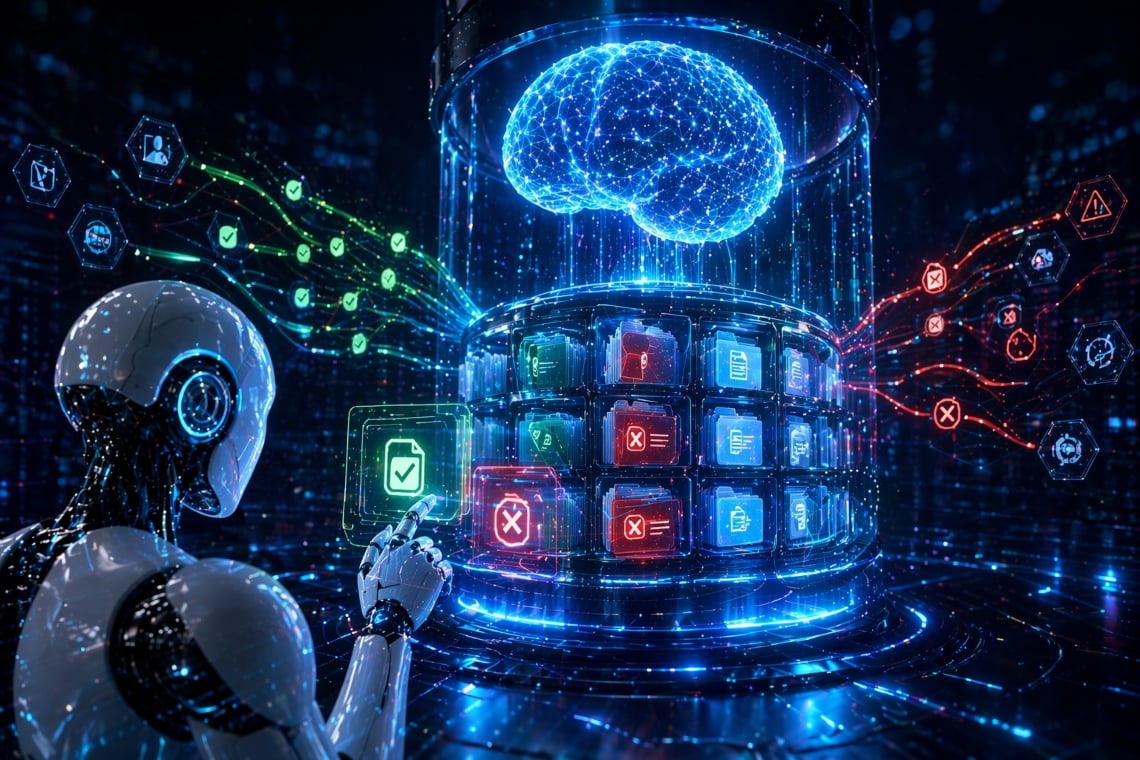
Özel olarak sistem üç aşamada çalışıyor. Görevden önce belleğin geri çağrılması, görevden sonra belleğin çıkarılması ve merkezi depoda belleğin pekiştirilmesi.
Bu da şu anlama geliyor: Yeni bir göreve başlamadan önce ajan, embedding tabanlı benzerlik aramasıyla geçmişteki en faydalı anıyı arıyor. Ardından bu içerik, bağlamsal rehber olarak başlangıç prompt’una ekleniyor.
Yürütmeden sonra sistem, neler olduğunu analiz ediyor ve strateji başlığı, kısa açıklama, operasyonel veya mantıksal içerikten oluşan yapılandırılmış bir bellek oluşturuyor. Her durumda asıl yenilik, hem başarıların hem de hataların kaydedilecek olması.
Bu sayede başarısız bir görev çöpe atılmıyor, aksine geleceğe yönelik önleyici bir derse dönüşüyor.
Hatanın değeri: neden önemli?
Ayrıca, araştırmanın en ilginç sonuçlarından biri geri çağrılan bellek miktarıyla ilgili.
Her ne kadar daha fazla anının daha iyi performansa denk geldiği düşünülebilse de, testler tam tersini gösteriyor. Yani örneğin, görev başına sadece tek bir bellek öğesinin geri çağrılmasının, dört öğe geri çağırmaya kıyasla daha iyi çalıştığı ortaya çıkıyor.
Bu da modern yapay zeka için önemli bir ilkeyi ima ediyor: önemli olan veri biriktirmek değil, doğru verileri seçmek.
Ayrıca bu, kurumsal pazar için de geçerli bir ders; pek çok şirket, etkili geri getirme sistemleri olmadan devasa bilgi tabanları biriktirmek için yarışıyor.
Ancak belirtildiği gibi, projenin en olgun aşamalarından biri tam da başarısızlığın bir kaynak olarak geri kazanılması.
Teknoloji tartışmalarında sık sık “benchmark kazanan” veya “görev çözen” modeller övülüyor, ancak pratikte ajanlar sık sık hata yapıyor. Yanlış düğmeye tıklayabiliyor, bir prompt’u yanlış yorumlayabiliyor veya verimsiz yollar seçebiliyorlar.
Yenilik, ReasoningBank’in bu hataları negatif kurallar oluşturmak için kullanmasında yatıyor: ne yapılmamalı, nerede ısrar edilmemeli, hangi sinyaller daha iyi yorumlanmalı.
Dolayısıyla bu yaklaşım, insan öğrenimine oldukça benziyor; zira bireyler de hatalardan öğrenerek ve neyin işe yaramadığını hatırlayarak daha fazla gelişiyor.
Sadece bu da değil, ana framework’ün yanında ekip MaTTS’i (memory-aware test-time scaling) tanıtıyor.
Pratikte sistem, aynı görev için mümkün olduğunca çok sayıda trajektori üretiyor ve başarılı ile başarısız denemeler arasındaki karşılaştırmaları kullanarak daha iyi anılar oluşturuyor.
Özel olarak iki mod bulunuyor: birden çok eşzamanlı denemeli paralel mod ve kademeli iyileştirmeli ardışık mod.
Şu ana kadar paralel mod, en karmaşık benchmark’larda daha iyi sonuçlar verdi. Bu da tek seferlik yanıt veren bir ajana sahip olmanın yeterli olmadığını, daha çok birden fazla yolu keşfedebilen ve her birinden öğrenebilen sistemler inşa etmenin önemli olduğunu gösteriyor.
Benchmark sonuçları ve Google Cloud’un asıl mesajı
WebArena, Mind2Web ve SWE-Bench-Verified testlerinde Google Cloud AI ReasoningBank, belleksiz baseline’ları ve çeşitli rakip sistemleri geride bıraktı.
Özellikle temel veriler arasında WebArena’da başarı oranında artış, görevleri tamamlamak için gereken ortalama adım sayısında azalma, alanlar arası görevlerde net ilerleme ve yazılım mühendisliği görevlerinde de daha iyi sonuçlar görüyoruz.
Bu önemli, çünkü belleğin yalnızca sohbet botları için değil, karmaşık operasyonel ajanlar için de işe yaradığını gösteriyor.
Ayrıca bu araştırmanın arkasında stratejik bir mesaj da var: bir sonraki yapay zeka rekabeti yalnızca dil modelleri arasında değil, kalıcı belleğe sahip ajan ekosistemleri arasında yaşanacak.
Dolayısıyla, zamanla gelişen, daha az hata yapan, bağlamlara uyum sağlayan ve benzeri özelliklere sahip ajanlar inşa edebilenler kaçınılmaz olarak büyük bir avantaj elde edecek.
Ayrıca bu, şu anda giderek daha otonom ajanlar geliştirmekle meşgul olan OpenAI, Anthropic, Microsoft ve Meta gibi rakiplere dolaylı bir yanıt niteliğinde.
Her ne kadar heyecan verici olsa da bazı kritik noktalar mevcut. Örneğin, yanlış anılar fazlaysa, buna bağlı olarak hatalar da büyütülüyor. Sistem hatalı bir dersi damıtırsa, ajan bu hatayı geleceğe taşıma riskiyle karşı karşıya kalıyor.
Ayrıca kurumsal ortamlarda etkileşimleri ve iş akışlarını hatırlamak, uyumluluk ve yönetişim sorunları yaratabilir.
Son olarak, vektör bellekleri, sıralama, geri getirme ve pekiştirme süreçlerini sürdürmek kayda değer kaynaklar gerektiriyor. Bu da framework ne kadar umut verici olursa olsun, geniş ölçekli endüstriyel uygulamasının kesinlikle kolay olmayacağı anlamına geliyor.